


នៅក្នុងអត្ថបទនេះ យើងនឹងពិនិត្យមើលតួនាទីសំខាន់នៃឯកសារ robots.txt ក្នុងការគ្រប់គ្រងចរាចរណ៍នៅលើគេហទំព័រ ពិភាក្សាពីភាពចាំបាច់នៃវត្តមានរបស់វា និងផ្តល់ការណែនាំសម្រាប់រៀបចំវាសម្រាប់ការគ្រប់គ្រងការបង្កើតលិបិក្រមទំព័រប្រកបដោយប្រសិទ្ធភាព។ លើសពីនេះទៀត យើងនឹងវិភាគឧទាហរណ៍នៃការប្រើប្រាស់ការណែនាំត្រឹមត្រូវនៅក្នុងឯកសារ robots.txt និងផ្តល់នូវការណែនាំអំពីរបៀបពិនិត្យមើលភាពត្រឹមត្រូវនៃការកំណត់របស់វា។
ហេតុអ្វីបានជា Robots.txt ត្រូវការ
Robots.txt គឺជាឯកសារដែលមានទីតាំងនៅលើម៉ាស៊ីនមេរបស់គេហទំព័រនៅក្នុងថត root របស់វា។ វាជូនដំណឹងដល់ម៉ាស៊ីនស្វែងរកមនុស្សយន្តអំពីរបៀបដែលពួកគេគួរស្កេនមាតិកានៃធនធាន។ ការប្រើប្រាស់ឯកសារនេះឱ្យបានត្រឹមត្រូវជួយការពារការបង្កើតលិបិក្រមនៃទំព័រដែលមិនចង់បាន ការពារទិន្នន័យសម្ងាត់ និងអាចបង្កើនប្រសិទ្ធភាពនៃការបង្កើនប្រសិទ្ធភាព SEO និងលទ្ធភាពមើលឃើញនៃគេហទំព័រនៅក្នុងលទ្ធផលស្វែងរក។ ការកំណត់រចនាសម្ព័ន្ធរបស់ robots.txt ត្រូវបានធ្វើឡើងតាមរយៈការណែនាំ ដែលយើងនឹងពិនិត្យមើលបន្ថែមទៀត។
ការកំណត់ការណែនាំនៅក្នុង Robots.txt
ភ្នាក់ងារអ្នកប្រើប្រាស់។
ការណែនាំចម្បងត្រូវបានគេស្គាល់ថាជា User-Agent ដែលយើងកំណត់ពាក្យគន្លឹះពិសេសសម្រាប់មនុស្សយន្ត។ នៅពេលរកឃើញពាក្យនេះ មនុស្សយន្តយល់ថាច្បាប់នេះមានគោលបំណងជាពិសេសសម្រាប់វា។
ពិចារណាឧទាហរណ៍នៃការប្រើប្រាស់ User-Agent នៅក្នុងឯកសារ robots.txt៖
User-Agent: *
Disallow: /private/
ឧទាហរណ៍នេះបង្ហាញថា មនុស្សយន្តស្វែងរកទាំងអស់ (តំណាងដោយនិមិត្តសញ្ញា " * ") គួរតែមិនអើពើទំព័រដែលមានទីតាំងនៅក្នុង ថត /private/ ។
នេះជារបៀបដែលការណែនាំស្វែងរកមនុស្សយន្តស្វែងរកជាក់លាក់៖
User-Agent: Googlebot
Disallow: /admin/

User-Agent: Bingbot
Disallow: /private/
ក្នុងករណីនេះ មនុស្សយន្តស្វែងរក Googlebot គួរតែមិនអើពើទំព័រនៅក្នុង ថត /admin/ ខណៈពេលដែល Bingbot គួរតែមិនអើពើទំព័រនៅក្នុង ថត /private/ ។
មិនអនុញ្ញាត
មិនអនុញ្ញាត ប្រាប់មនុស្សយន្តស្វែងរកថាតើ URL ណាខ្លះដែលត្រូវរំលង ឬមិនត្រូវដាក់លិបិក្រមនៅលើគេហទំព័រ។ ការណែនាំនេះមានប្រយោជន៍នៅពេលអ្នកចង់លាក់ទិន្នន័យរសើប ឬទំព័រមាតិកាដែលមានគុណភាពទាបពីការត្រូវបានដាក់លិបិក្រមដោយម៉ាស៊ីនស្វែងរក។ ប្រសិនបើឯកសារ robots.txt មានធាតុ មិនអនុញ្ញាត: /directory/ នោះមនុស្សយន្តនឹងត្រូវបានបដិសេធមិនឱ្យចូលប្រើខ្លឹមសារនៃថតដែលបានបញ្ជាក់។ ឧទាហរណ៍
User-agent: *
Disallow: /admin/
តម្លៃនេះបង្ហាញថា មនុស្សយន្តទាំងអស់ គួរតែមិនអើពើ URL ដែលចាប់ផ្តើមដោយ /admin/ ។ ដើម្បីរារាំងគេហទំព័រទាំងមូលពីការត្រូវបានធ្វើលិបិក្រមដោយមនុស្សយន្តណាមួយ សូមកំណត់ថតឯកសារ root ជាច្បាប់៖
User-agent: *
Disallow: /
អនុញ្ញាតឱ្យ
តម្លៃ "អនុញ្ញាត" ធ្វើសកម្មភាពផ្ទុយទៅនឹង "មិនអនុញ្ញាត"៖ វាអនុញ្ញាតឱ្យមនុស្សយន្តស្វែងរកចូលប្រើទំព័រ ឬថតជាក់លាក់មួយ ទោះបីជាការណែនាំផ្សេងទៀតនៅក្នុងឯកសារ robots.txt ហាមឃាត់ការចូលប្រើវាក៏ដោយ។
ពិចារណាឧទាហរណ៍មួយ៖
User-agent: *
Disallow: /admin/
Allow: /admin/login.html
នៅក្នុងឧទាហរណ៍នេះ វាត្រូវបានបញ្ជាក់ថា មនុស្សយន្តមិនត្រូវបានអនុញ្ញាតឱ្យចូលប្រើ ថត /admin/ ទេ លើកលែងតែ ទំព័រ /admin/login.html ដែលអាចរកបានសម្រាប់ការធ្វើលិបិក្រម និងការស្កេន។
Robots.txt និង Sitemap
Sitemap គឺជាឯកសារ XML ដែលមានបញ្ជី URL នៃទំព័រ និងឯកសារទាំងអស់នៅលើគេហទំព័រដែលអាចធ្វើលិបិក្រមដោយម៉ាស៊ីនស្វែងរក។ នៅពេលដែលមនុស្សយន្តស្វែងរកចូលប្រើឯកសារ robots.txt ហើយឃើញតំណទៅកាន់ឯកសារ XML ផែនទីគេហទំព័រ វាអាចប្រើឯកសារនេះដើម្បីស្វែងរក URL និងធនធានដែលមានទាំងអស់នៅលើគេហទំព័រ។ ការណែនាំត្រូវបានបញ្ជាក់ជាទម្រង់៖
Sitemap: https://yoursite.com/filesitemap.xmlច្បាប់នេះជាធម្មតាត្រូវបានដាក់នៅចុងបញ្ចប់នៃឯកសារដោយមិនត្រូវបានចងភ្ជាប់ទៅនឹង User-Agent ជាក់លាក់ទេ ហើយត្រូវបានដំណើរការដោយមនុស្សយន្តទាំងអស់ដោយគ្មានករណីលើកលែង។ ប្រសិនបើម្ចាស់គេហទំព័រមិនប្រើ sitemap.xml វាមិនចាំបាច់ក្នុងការបន្ថែមច្បាប់នោះទេ។
ឧទាហរណ៍នៃការកំណត់រចនាសម្ព័ន្ធ Robots.txt
ការដំឡើង Robots.txt សម្រាប់ WordPress
នៅក្នុងផ្នែកនេះ យើងនឹងពិចារណាអំពីការកំណត់រចនាសម្ព័ន្ធដែលត្រៀមរួចជាស្រេចសម្រាប់ WordPress ។ យើងនឹងរុករកការទប់ស្កាត់ការចូលប្រើទិន្នន័យសម្ងាត់ និងអនុញ្ញាតឱ្យចូលទៅកាន់ទំព័រមេ។
ជាដំណោះស្រាយរួចរាល់ អ្នកអាចប្រើកូដខាងក្រោម៖
User-agent: *
# Block access to files containing confidential data
Disallow: /cgi-bin
Disallow: /wp-admin/
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /xmlrpc.php

# Allow access to the main site pages
Allow: /wp-content/uploads/
Allow: /sitemap.xml
Allow: /feed/
Allow: /trackback/
Allow: /comments/feed/
Allow: /category/*/*
Allow: /tag/*

# Prohibit the indexing of old versions of posts and parameterized queries to avoid content duplication or suboptimal indexing.
Disallow: /*?*
Disallow: /?s=*
Disallow: /?p=*
Disallow: /?page_id=*
Disallow: /?cat=*
Disallow: /?tag=*

# Include the sitemap (location needs to be replaced with your own)
Sitemap: http://yourdomain.com/sitemap.xml
ទោះបីជាការណែនាំទាំងអស់ត្រូវបានអមដោយមតិយោបល់ក៏ដោយ ចូរយើងស្វែងយល់ឱ្យកាន់តែស៊ីជម្រៅទៅក្នុងសេចក្តីសន្និដ្ឋាន។
- មនុស្សយន្តនឹងមិនធ្វើលិបិក្រមឯកសារ និងថតឯកសាររសើបទេ។
- ក្នុងពេលជាមួយគ្នានេះ មនុស្សយន្តត្រូវបានអនុញ្ញាតឱ្យចូលទៅកាន់ទំព័រមេ និងធនធាននៃគេហទំព័រ។
- ការហាមប្រាមត្រូវបានកំណត់នៅលើការបង្កើតលិបិក្រមកំណែចាស់នៃប្រកាស និងសំណួរដែលកំណត់ប៉ារ៉ាម៉ែត្រដើម្បីការពារការចម្លងមាតិកា។
- ទីតាំងនៃផែនទីគេហទំព័រត្រូវបានចង្អុលបង្ហាញសម្រាប់ការធ្វើលិបិក្រមដែលប្រសើរឡើង។
ដូច្នេះ យើងបានពិចារណាឧទាហរណ៍ទូទៅនៃការកំណត់រចនាសម្ព័ន្ធដែលត្រៀមរួចជាស្រេច ដែលឯកសារ និងផ្លូវរសើបមួយចំនួនត្រូវបានលាក់ពីការធ្វើលិបិក្រម ប៉ុន្តែថតឯកសារសំខាន់ៗអាចចូលប្រើបាន។
មិនដូច CMS ដ៏ពេញនិយម ឬគេហទំព័រដែលសរសេរតាមតម្រូវការជាច្រើនទេ WordPress មានកម្មវិធីជំនួយជាច្រើនដែលជួយសម្រួលដល់ការបង្កើត និងការគ្រប់គ្រងឯកសារ robots.txt។ ដំណោះស្រាយដ៏ពេញនិយមមួយសម្រាប់គោលបំណងនេះគឺ Yoast SEO ។
ដើម្បីដំឡើងវាអ្នកត្រូវ៖
- ចូលទៅកាន់ផ្ទាំងគ្រប់គ្រង WordPress ។
- នៅក្នុងផ្នែក "កម្មវិធីជំនួយ" ជ្រើសរើស "បន្ថែមថ្មី" ។
- ស្វែងរកកម្មវិធីជំនួយ "Yoast SEO" ហើយដំឡើងវា។
- ធ្វើសកម្មភាពកម្មវិធីជំនួយ។
ដើម្បីកែសម្រួលឯកសារ robots.txt អ្នកត្រូវ៖
- ចូលទៅកាន់ផ្នែក "SEO" នៅក្នុងម៉ឺនុយចំហៀងរបស់ផ្ទាំងគ្រប់គ្រងហើយជ្រើសរើស "ទូទៅ" ។
- ចូលទៅកាន់ផ្ទាំង "ឧបករណ៍" ។
- ចុចលើ "ឯកសារ" ។ នៅទីនេះអ្នកនឹងឃើញឯកសារផ្សេងៗ រួមទាំង robots.txt ផងដែរ។
- បញ្ចូលច្បាប់ធ្វើលិបិក្រមចាំបាច់ ស្របតាមតម្រូវការរបស់អ្នក។
- បន្ទាប់ពីធ្វើការផ្លាស់ប្តូរឯកសារ សូមចុចប៊ូតុង "រក្សាទុកការផ្លាស់ប្ដូរទៅ robots.txt"។
ចំណាំថាការកំណត់ឯកសារ robots.txt នីមួយៗសម្រាប់ប្លក, រូបភាពគឺមានតែមួយគត់ និងអាស្រ័យលើតម្រូវការជាក់លាក់ និងលក្ខណៈពិសេសរបស់គេហទំព័រ។ មិនមានគំរូសកលដែលសាកសមនឹងធនធានទាំងអស់ដោយគ្មានករណីលើកលែងនោះទេ។ ទោះយ៉ាងណាក៏ដោយ ឧទាហរណ៍នេះ និងការប្រើប្រាស់កម្មវិធីជំនួយអាចជួយសម្រួលកិច្ចការយ៉ាងសំខាន់។
ការកំណត់ដោយដៃរបស់ Robots.txt
ស្រដៀងគ្នានេះដែរ អ្នកអាចរៀបចំការកំណត់រចនាសម្ព័ន្ធឯកសាររបស់អ្នក ទោះបីជាមិនមាន CMS រួចរាល់សម្រាប់គេហទំព័រក៏ដោយ។ អ្នកប្រើប្រាស់ក៏ត្រូវផ្ទុកឡើងឯកសារ robots.txt ទៅកាន់ថត root នៃគេហទំព័រ និងបញ្ជាក់ច្បាប់ចាំបាច់។ នេះគឺជាឧទាហរណ៍មួយក្នុងចំណោមឧទាហរណ៍ ដែលការណែនាំដែលមានទាំងអស់ត្រូវបានចង្អុលបង្ហាញ៖
User-agent: *
Disallow: /admin/             # Prohibit access to the administrative panel
Disallow: /secret.html	      # Prohibit access to a specific file
Disallow: /*.pdf$	      # Prohibit indexing of certain file types
Disallow: /*?sort=	      # Prohibit indexing of certain URL parameters
Allow: /public/		      # Allow access to public pages
Sitemap: http://yourdomain.com/sitemap.xml # Include the sitemap
របៀបពិនិត្យមើលឯកសារ Robots.txt
ជាឧបករណ៍ជំនួយនៅពេលពិនិត្យឯកសារ robots.txt សម្រាប់កំហុស វាត្រូវបានណែនាំឱ្យប្រើសេវាកម្មអនឡាញ។
សូមពិចារណាឧទាហរណ៍នៃ សេវាកម្ម Yandex Webmaster ។ ដើម្បីពិនិត្យមើល អ្នកត្រូវបញ្ចូលតំណភ្ជាប់ទៅកាន់គេហទំព័ររបស់អ្នកនៅក្នុងវាលដែលត្រូវគ្នា ប្រសិនបើឯកសារត្រូវបានផ្ទុកឡើងទៅម៉ាស៊ីនមេរួចហើយ។ បន្ទាប់ពីនោះ ឧបករណ៍ខ្លួនវានឹងផ្ទុកការកំណត់រចនាសម្ព័ន្ធឯកសារ។ មានជម្រើសមួយដើម្បីបញ្ចូលការកំណត់រចនាសម្ព័ន្ធដោយដៃផងដែរ៖
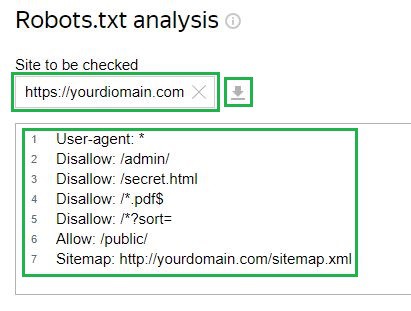
បន្ទាប់អ្នកត្រូវស្នើសុំការត្រួតពិនិត្យ ហើយរង់ចាំលទ្ធផល៖
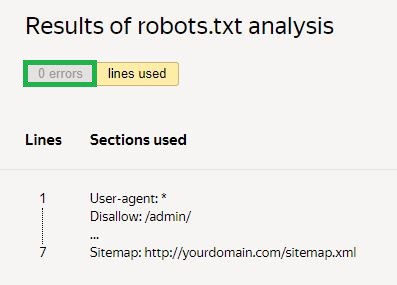
នៅក្នុងឧទាហរណ៍ដែលបានផ្តល់ឱ្យមិនមានកំហុសទេ។ ប្រសិនបើមាន សេវាកម្មនឹងបង្ហាញផ្នែកដែលមានបញ្ហា និងវិធីដើម្បីជួសជុលពួកគេ។
សន្និដ្ឋាន
សរុបមក យើងបានសង្កត់ធ្ងន់ថាតើឯកសារ robots.txt មានសារៈសំខាន់ប៉ុណ្ណាសម្រាប់ការគ្រប់គ្រងចរាចរណ៍នៅលើគេហទំព័រ។ យើងបានផ្តល់ដំបូន្មានអំពីរបៀបរៀបចំវាឱ្យបានត្រឹមត្រូវ ដើម្បីគ្រប់គ្រងរបៀបដែលទំព័រលិបិក្រមរបស់ម៉ាស៊ីនស្វែងរក។ បន្ថែមពីលើនេះ យើងក៏បានពិនិត្យមើលឧទាហរណ៍អំពីរបៀបប្រើឯកសារនេះឱ្យបានត្រឹមត្រូវ និងបានផ្តល់ការណែនាំអំពីរបៀបពិនិត្យមើលថាការកំណត់ទាំងអស់ដំណើរការត្រឹមត្រូវ។
