


Yn dit artikel sille wy de kaairol fan 'e robots.txt-bestân ûndersiikje by it behearen fan ferkear op websiden, beprate de needsaak fan syn oanwêzigens, en oanbefellings leverje foar it ynstellen fan it foar effektyf side-yndeksearringsbehear. Derneist sille wy foarbylden analysearje fan korrekt gebrûk fan rjochtlinen yn 'e robots.txt-bestân en in hantlieding leverje oer hoe't jo de krektens fan har ynstellingen kontrolearje kinne.
Wêrom Robots.txt is nedich
Robots.txt is in bestân dat op de tsjinner fan 'e side leit yn syn root-map. It ynformearret sykmasjinerobots hoe't se de ynhâld fan 'e boarne moatte scannen. Goed gebrûk fan dit bestân helpt it yndeksearjen fan net-winske siden te foarkommen, beskermet fertroulike gegevens, en kin de effisjinsje fan SEO-optimalisaasje en sichtberens fan 'e side yn sykresultaten ferbetterje. De konfiguraasje fan robots.txt wurdt dien troch rjochtlinen, dy't wy fierder sille sjen.
Ynstelle rjochtlinen yn Robots.txt
Meidogger-agint
De primêre rjochtline is bekend as User-Agent, wêr't wy in spesjaal kaaiwurd ynstelle foar robots. By it ûntdekken fan dit wurd begrypt de robot dat de regel der spesifyk foar bedoeld is.
Beskôgje in foarbyld fan it brûken fan User-Agent yn it robots.txt-bestân:
User-Agent: *
Disallow: /private/
Dit foarbyld jout oan dat alle sykrobots (oantsjutte troch it symboal " * ") siden yn 'e /private/ -map negearje moatte.
Hjir is hoe't de ynstruksje derút sjocht foar spesifike sykrobots:
User-Agent: Googlebot
Disallow: /admin/

User-Agent: Bingbot
Disallow: /private/
Yn dit gefal moat de sykrobot fan Googlebot siden yn 'e map /admin/ negearje , wylst Bingbot siden yn 'e map /private/ negearje moat.
Net tastean
Disallow fertelt sykmasjine-robots hokker URL's se oerslaan of net yndeksearje moatte op 'e webside. Dizze rjochtline is nuttich as jo gefoelige gegevens of siden fan lege kwaliteit ferbergje wolle foar yndeksearring troch sykmasjines. As it robots.txt-bestân de yngong Disallow: /directory/ befettet , dan wurdt robots de tagong ta de ynhâld fan 'e oantsjutte map ûntsein. Bygelyks,
User-agent: *
Disallow: /admin/
Dizze wearde jout oan dat alle robots URL's dy't begjinne mei /admin/ negearje moatte . Om te foarkommen dat de hiele side troch robots yndeksearre wurdt, stel de root directory yn as regel:
User-agent: *
Disallow: /
Tastean
De "Tastean"-wearde wurket tsjinoer "Disallow": it jout sykrobots tagong ta in spesifike side of map, sels as oare rjochtlinen yn it robots.txt-bestân tagong dêrta ferbiede.
Beskôgje in foarbyld:
User-agent: *
Disallow: /admin/
Allow: /admin/login.html
Yn dit foarbyld wurdt oanjûn dat robots gjin tagong hawwe ta de /admin/ -map, útsein de /admin/login.html-side , dy't beskikber is foar yndeksearjen en scannen.
Robots.txt en Sitemap
Sitemap is in XML-bestân dat in list mei URL's befettet fan alle siden en bestannen op 'e side dy't kinne wurde yndeksearre troch sykmasines. As in sykrobot tagong hat ta it robots.txt-bestân en in keppeling sjocht nei in XML-bestân foar sitemap, kin it dit bestân brûke om alle beskikbere URL's en boarnen op 'e side te finen. De rjochtline is spesifisearre yn it formaat:
Sitemap: https://yoursite.com/filesitemap.xmlDizze regel wurdt normaal pleatst oan 'e ein fan it dokumint sûnder te wêzen bûn oan in spesifike User-Agent en wurdt ferwurke troch alle robots sûnder útsûndering. As de side-eigner gjin sitemap.xml brûkt, is it net nedich om de regel ta te foegjen.
Foarbylden fan ynsteld Robots.txt
Robots.txt ynstelle foar WordPress
Yn dizze seksje sille wy in klearmakke konfiguraasje foar WordPress beskôgje. Wy sille ûndersykje it blokkearjen fan tagong ta fertroulike gegevens en it tastean fan tagong ta de haadsiden.
As kleare oplossing kinne jo de folgjende koade brûke:
User-agent: *
# Block access to files containing confidential data
Disallow: /cgi-bin
Disallow: /wp-admin/
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /xmlrpc.php

# Allow access to the main site pages
Allow: /wp-content/uploads/
Allow: /sitemap.xml
Allow: /feed/
Allow: /trackback/
Allow: /comments/feed/
Allow: /category/*/*
Allow: /tag/*

# Prohibit the indexing of old versions of posts and parameterized queries to avoid content duplication or suboptimal indexing.
Disallow: /*?*
Disallow: /?s=*
Disallow: /?p=*
Disallow: /?page_id=*
Disallow: /?cat=*
Disallow: /?tag=*

# Include the sitemap (location needs to be replaced with your own)
Sitemap: http://yourdomain.com/sitemap.xml
Hoewol't alle rjochtlinen wurde begelaat troch opmerkings, lit ús dûke djipper yn 'e konklúzjes.
- Robots sille gjin gefoelige bestannen en mappen yndeksearje.
- Tagelyk kinne robots tagong krije ta de haadsiden en boarnen fan 'e side.
- ban is ynsteld op it yndeksearjen fan âlde ferzjes fan berjochten en parameterisearre queries om ynhâldduplikaasje te foarkommen.
- De lokaasje fan 'e sitemap wurdt oanjûn foar ferbettere yndeksearring.
Sa hawwe wy beskôge as in algemien foarbyld fan in klear konfiguraasje, wêryn guon gefoelige triemmen en paden binne ferburgen foar yndeksearring, mar de wichtichste mappen binne tagonklik.
Oars as in protte populêre CMS- of oanpaste siden, hat WordPress ferskate plugins dy't it meitsjen en behearen fan it robots.txt-bestân fasilitearje. Ien fan 'e populêre oplossingen hjirfoar is Yoast SEO.
Om it te ynstallearjen, moatte jo:
- Gean nei it WordPress adminpaniel.
- Yn de seksje "Plugins" selektearje "Nije tafoegje".
- Fyn de "Yoast SEO" plugin en ynstallearje it.
- Aktivearje it plugin.
Om it robots.txt-bestân te bewurkjen, moatte jo:
- Gean nei de seksje "SEO" yn it sydmenu fan it adminpaniel en selektearje "Algemien".
- Gean nei it ljepblêd "Tools".
- Klik op "Triemen". Hjir sille jo ferskate triemmen sjen, ynklusyf robots.txt.
- Fier de nedige yndeksearringsregels yn neffens jo easken.
- Nei it meitsjen fan wizigingen yn it bestân, klikje jo op de knop "Bewarje wizigingen yn robots.txt".
Tink derom dat elke robots.txt-bestânynstelling foar WordPress unyk is en hinget ôf fan 'e spesifike behoeften en funksjes fan' e side. D'r is gjin universele sjabloan dat soe passe alle boarnen sûnder útsûndering. Dit foarbyld en it brûken fan plugins kinne lykwols de taak signifikant ferienfâldigje.
Hânlieding Ynstelling fan Robots.txt
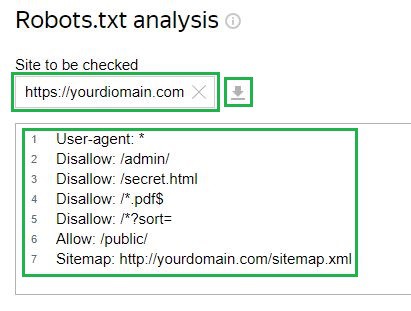
Op deselde manier kinne jo jo konfiguraasje fan it bestân ynstelle, sels by it ûntbrekken fan in klear CMS foar de side. De brûker moat ek it robots.txt-bestân uploade nei de root-map fan 'e side en de nedige regels opjaan. Hjir is ien fan 'e foarbylden, wêryn alle beskikbere rjochtlinen binne oanjûn:
User-agent: *
Disallow: /admin/             # Prohibit access to the administrative panel
Disallow: /secret.html	      # Prohibit access to a specific file
Disallow: /*.pdf$	      # Prohibit indexing of certain file types
Disallow: /*?sort=	      # Prohibit indexing of certain URL parameters
Allow: /public/		      # Allow access to public pages
Sitemap: http://yourdomain.com/sitemap.xml # Include the sitemap
Hoe kinne jo it Robots.txt-bestân kontrolearje
As helpmiddel by it kontrolearjen fan it robots.txt-bestân op flaters, is it oan te rieden om online tsjinsten te brûken.
Beskôgje it foarbyld fan 'e Yandex Webmaster- tsjinst. Om te kontrolearjen, moatte jo in keppeling nei jo side yn it oerienkommende fjild ynfoegje as it bestân al nei de server is uploaden. Dêrnei sil it ark sels de bestânskonfiguraasje lade. D'r is ek in opsje om de konfiguraasje manuell yn te fieren:
Folgjende moatte jo in kontrôle oanfreegje en wachtsje op de resultaten:
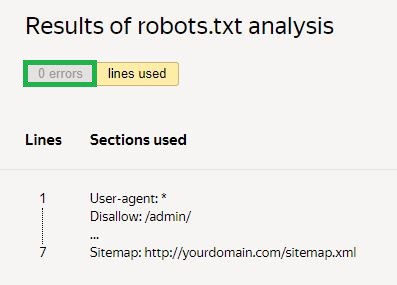
Yn it opjûne foarbyld binne d'r gjin flaters. As d'r ien binne, sil de tsjinst de problematyske gebieten sjen litte en manieren om se te reparearjen.
Konklúzje
Gearfetsjend hawwe wy beklamme hoe wichtich it robots.txt-bestân is foar it kontrolearjen fan ferkear op 'e side. Wy joegen advys oer hoe't jo it goed kinne ynstelle om te behearjen hoe't sykmasjines siden yndeksearje. Njonken dit, hawwe wy ek sjoen nei foarbylden fan hoe't jo dit bestân korrekt brûke en joegen ynstruksjes oer hoe't jo kinne kontrolearje dat alle ynstellingen goed wurkje.
