


در این مقاله به بررسی نقش کلیدی فایل robots.txt در مدیریت ترافیک وب سایت ها، ضرورت وجود آن و ارائه توصیه هایی برای راه اندازی آن برای مدیریت موثر نمایه سازی صفحات می پردازیم. علاوه بر این، نمونههایی از استفاده صحیح از دستورالعملها را در فایل robots.txt تجزیه و تحلیل خواهیم کرد و راهنمایی در مورد چگونگی بررسی صحت تنظیمات آن ارائه میکنیم.
چرا Robots.txt مورد نیاز است
Robots.txt فایلی است که روی سرور سایت در دایرکتوری ریشه آن قرار دارد. به ربات های موتورهای جستجو اطلاع می دهد که چگونه باید محتوای منبع را اسکن کنند. استفاده صحیح از این فایل به جلوگیری از ایندکس شدن صفحات ناخواسته کمک می کند، از داده های محرمانه محافظت می کند و می تواند کارایی بهینه سازی سئو و دیده شدن سایت در نتایج جستجو را بهبود بخشد. پیکربندی robots.txt از طریق دایرکتیوهایی انجام می شود که در ادامه به بررسی آن خواهیم پرداخت.
تنظیم دستورالعمل ها در Robots.txt
نماینده کاربر
دستورالعمل اولیه به عنوان User-Agent شناخته می شود، جایی که ما یک کلمه کلیدی ویژه برای روبات ها تعیین می کنیم. با تشخیص این کلمه، ربات متوجه می شود که این قانون به طور خاص برای آن در نظر گرفته شده است.
مثالی از استفاده از User-Agent در فایل robots.txt را در نظر بگیرید:
User-Agent: *
Disallow: /private/
این مثال نشان میدهد که همه رباتهای جستجو (که با نماد " * " نمایش داده میشوند) باید صفحاتی را که در دایرکتوری /private/ قرار دارند، نادیده بگیرند.
در اینجا نحوه نگاه کردن دستورالعمل برای روبات های جستجوگر خاص است:
User-Agent: Googlebot
Disallow: /admin/

User-Agent: Bingbot
Disallow: /private/
در این حالت، ربات جستجوی Googlebot باید صفحات موجود در دایرکتوری /admin/ را نادیده بگیرد ، در حالی که Bingbot باید صفحات موجود در دایرکتوری /private/ را نادیده بگیرد.
نپذیرفتن
Disallow به رباتهای جستجو میگوید که کدام URLها را در وبسایت نادیده بگیرند یا ایندکس نکنند. این دستور زمانی مفید است که میخواهید دادههای حساس یا صفحات با محتوای بیکیفیت را از ایندکس شدن توسط موتورهای جستجو پنهان کنید. اگر فایل robots.txt حاوی ورودی Disallow: /directory/ باشد ، رباتها از دسترسی به محتوای دایرکتوری مشخص شده محروم میشوند. به عنوان مثال،
User-agent: *
Disallow: /admin/
این مقدار نشان میدهد که همه رباتها باید URLهایی که با /admin/ شروع میشوند را نادیده بگیرند . برای جلوگیری از ایندکس شدن کل سایت توسط هر رباتی، دایرکتوری ریشه را به عنوان یک قانون تنظیم کنید:
User-agent: *
Disallow: /
اجازه دادن
مقدار "Allow" برخلاف "Disallow" عمل میکند: به رباتهای جستجوگر اجازه میدهد به صفحه یا فهرستی خاص دسترسی داشته باشند، حتی اگر دستورالعملهای دیگر در فایل robots.txt دسترسی به آن را ممنوع کنند.
به یک مثال توجه کنید:
User-agent: *
Disallow: /admin/
Allow: /admin/login.html
در این مثال، مشخص شده است که رباتها اجازه دسترسی به دایرکتوری /admin/ را ندارند ، به جز صفحه /admin/login.html که برای فهرستبندی و اسکن در دسترس است.
Robots.txt و Sitemap
نقشه سایت یک فایل XML است که حاوی لیستی از URLهای تمام صفحات و فایل های موجود در سایت است که می توانند توسط موتورهای جستجو ایندکس شوند. هنگامی که یک ربات جستجوگر به فایل robots.txt دسترسی پیدا می کند و پیوندی به فایل XML نقشه سایت می بیند، می تواند از این فایل برای یافتن همه URL ها و منابع موجود در سایت استفاده کند. بخشنامه در قالب مشخص شده است:
Sitemap: https://yoursite.com/filesitemap.xmlاین قانون معمولاً بدون اینکه به یک User-Agent خاص گره بخورد در انتهای سند قرار می گیرد و توسط همه ربات ها بدون استثنا پردازش می شود. اگر صاحب سایت از sitemap.xml استفاده نمی کند، اضافه کردن قانون ضروری نیست.
نمونه هایی از Robots.txt پیکربندی شده
راه اندازی Robots.txt برای وردپرس
در این قسمت یک پیکربندی آماده برای وردپرس را در نظر خواهیم گرفت. ما مسدود کردن دسترسی به داده های محرمانه و اجازه دسترسی به صفحات اصلی را بررسی خواهیم کرد.
به عنوان راه حل آماده می توانید از کد زیر استفاده کنید:
User-agent: *
# Block access to files containing confidential data
Disallow: /cgi-bin
Disallow: /wp-admin/
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /xmlrpc.php

# Allow access to the main site pages
Allow: /wp-content/uploads/
Allow: /sitemap.xml
Allow: /feed/
Allow: /trackback/
Allow: /comments/feed/
Allow: /category/*/*
Allow: /tag/*

# Prohibit the indexing of old versions of posts and parameterized queries to avoid content duplication or suboptimal indexing.
Disallow: /*?*
Disallow: /?s=*
Disallow: /?p=*
Disallow: /?page_id=*
Disallow: /?cat=*
Disallow: /?tag=*

# Include the sitemap (location needs to be replaced with your own)
Sitemap: http://yourdomain.com/sitemap.xml
اگرچه همه دستورالعمل ها با نظراتی همراه هستند، بیایید عمیق تر به نتیجه گیری بپردازیم.
- ربات ها فایل ها و دایرکتوری های حساس را ایندکس نمی کنند.
- در عین حال، ربات ها اجازه دسترسی به صفحات و منابع اصلی سایت را دارند.
- ممنوعیت ایندکس کردن نسخه های قدیمی پست ها و پرس و جوهای پارامتر شده برای جلوگیری از تکرار محتوا تنظیم شده است.
- مکان نقشه سایت برای نمایه سازی بهتر مشخص شده است.
بنابراین، ما یک مثال کلی از یک پیکربندی آماده را در نظر گرفتهایم که در آن برخی از فایلها و مسیرهای حساس از نمایهسازی پنهان هستند، اما دایرکتوریهای اصلی قابل دسترسی هستند.
برخلاف بسیاری از سیستمهای مدیریت محتوای محبوب یا سایتهای سفارشی، وردپرس افزونههای متعددی دارد که ایجاد و مدیریت فایل robots.txt را تسهیل میکنند. یکی از راهحلهای محبوب برای این منظور Yoast SEO است.
برای نصب آن باید:
- به پنل مدیریت وردپرس بروید.
- در بخش «افزونهها»، «افزودن جدید» را انتخاب کنید.
- افزونه Yoast SEO را پیدا کرده و نصب کنید.
- پلاگین را فعال کنید
برای ویرایش فایل robots.txt، باید:
- به بخش "SEO" در منوی کناری پنل مدیریت بروید و "General" را انتخاب کنید.
- به تب "ابزار" بروید.
- روی "Files" کلیک کنید. در اینجا فایل های مختلفی از جمله robots.txt را مشاهده خواهید کرد.
- قوانین نمایه سازی لازم را با توجه به نیاز خود وارد کنید.
- پس از ایجاد تغییرات در فایل، روی دکمه "ذخیره تغییرات در robots.txt" کلیک کنید.
توجه داشته باشید که تنظیمات هر فایل robots.txt برای وردپرس منحصر به فرد است و به نیازها و ویژگی های خاص سایت بستگی دارد. هیچ الگوی جهانی وجود ندارد که بدون استثنا برای همه منابع مناسب باشد. با این حال، این مثال و استفاده از افزونه ها می تواند کار را به طور قابل توجهی ساده کند.
تنظیم دستی Robots.txt
به طور مشابه، می توانید پیکربندی فایل خود را حتی در صورت عدم وجود یک CMS آماده برای سایت تنظیم کنید. کاربر همچنین باید فایل robots.txt را در فهرست اصلی سایت آپلود کند و قوانین لازم را مشخص کند. در اینجا یکی از نمونه ها آمده است که در آن تمام دستورالعمل های موجود نشان داده شده است:
User-agent: *
Disallow: /admin/             # Prohibit access to the administrative panel
Disallow: /secret.html	      # Prohibit access to a specific file
Disallow: /*.pdf$	      # Prohibit indexing of certain file types
Disallow: /*?sort=	      # Prohibit indexing of certain URL parameters
Allow: /public/		      # Allow access to public pages
Sitemap: http://yourdomain.com/sitemap.xml # Include the sitemap
چگونه فایل Robots.txt را بررسی کنیم
به عنوان یک ابزار کمکی هنگام بررسی فایل robots.txt برای وجود خطا، توصیه می شود از خدمات آنلاین استفاده کنید.
به عنوان مثال سرویس Yandex Webmaster را در نظر بگیرید . برای بررسی، اگر فایل از قبل در سرور آپلود شده است، باید لینکی به سایت خود در فیلد مربوطه وارد کنید. پس از آن، خود ابزار پیکربندی فایل را بارگذاری میکند. همچنین گزینهای برای وارد کردن دستی پیکربندی وجود دارد:
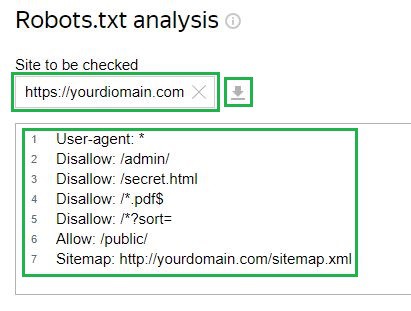
در مرحله بعد، باید درخواست بررسی کنید و منتظر نتایج باشید:
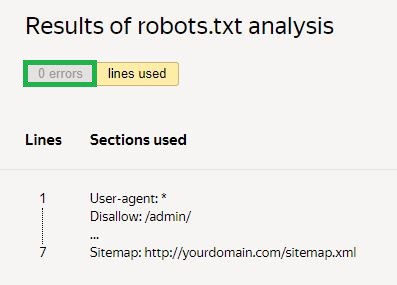
در مثال ارائه شده، هیچ خطایی وجود ندارد. در صورت وجود، سرویس مناطق مشکل دار و راه های رفع آنها را نشان می دهد.
نتیجه
به طور خلاصه تاکید کردیم که فایل robots.txt چقدر برای کنترل ترافیک سایت اهمیت دارد. ما توصیه هایی در مورد نحوه تنظیم صحیح آن برای مدیریت نحوه فهرست بندی صفحات توسط موتورهای جستجو ارائه کردیم. علاوه بر این، نمونههایی از نحوه استفاده صحیح از این فایل را نیز بررسی کردیم و دستورالعملهایی را در مورد چگونگی بررسی درست کار کردن همه تنظیمات ارائه کردیم.
