


In diesem Artikel untersuchen wir die Schlüsselrolle der robots.txt-Datei bei der Steuerung des Website-Verkehrs, diskutieren die Notwendigkeit ihrer Verwendung und geben Empfehlungen für deren Einrichtung für eine effektive Seitenindexierung. Darüber hinaus analysieren wir Beispiele für die korrekte Verwendung von Anweisungen in der robots.txt-Datei und geben eine Anleitung zur Überprüfung der Richtigkeit ihrer Einstellungen.
Warum Robots.txt benötigt wird
Robots.txt ist eine Datei, die sich im Stammverzeichnis des Website-Servers befindet. Sie informiert Suchmaschinen-Roboter darüber, wie sie den Inhalt der Ressource scannen sollen. Die korrekte Verwendung dieser Datei verhindert die Indexierung unerwünschter Seiten, schützt vertrauliche Daten und verbessert die Effizienz der SEO-Optimierung sowie die Sichtbarkeit der Website in Suchergebnissen. Die Konfiguration von robots.txt erfolgt über Direktiven, die wir uns genauer ansehen werden.
Festlegen von Anweisungen in Robots.txt
User-Agent
Die primäre Direktive heißt User-Agent und definiert ein spezielles Schlüsselwort für Roboter. Sobald der Roboter dieses Wort erkennt, versteht er, dass die Regel speziell für ihn bestimmt ist.
Betrachten Sie ein Beispiel für die Verwendung von User-Agent in der Datei robots.txt:
User-Agent: *
Disallow: /private/
Dieses Beispiel zeigt an, dass alle Suchmaschinen-Roboter (dargestellt durch das Symbol " * ") Seiten im Verzeichnis /private/ ignorieren sollen.
So sieht die Anleitung für bestimmte Suchroboter aus:
User-Agent: Googlebot
Disallow: /admin/

User-Agent: Bingbot
Disallow: /private/
In diesem Fall sollte der Googlebot- Suchmaschinenroboter Seiten im Verzeichnis /admin/ ignorieren , während Bingbot Seiten im Verzeichnis /private/ ignorieren sollte.
ablehnen
Die Anweisung „Disallow“ teilt Suchmaschinen-Robotern mit, welche URLs auf der Website übersprungen oder nicht indexiert werden sollen. Diese Anweisung ist nützlich, wenn Sie sensible Daten oder minderwertige Inhalte vor der Indexierung durch Suchmaschinen verbergen möchten. Enthält die robots.txt-Datei den Eintrag „Disallow: /Verzeichnis/“ , wird Suchmaschinen-Robotern der Zugriff auf den Inhalt des angegebenen Verzeichnisses verweigert. Zum Beispiel:
User-agent: *
Disallow: /admin/
Dieser Wert gibt an, dass alle Bots URLs, die mit /admin/ beginnen, ignorieren sollen . Um zu verhindern, dass die gesamte Website von Bots indexiert wird, legen Sie das Stammverzeichnis als Regel fest:
User-agent: *
Disallow: /
Erlauben
Der Wert „Allow“ verhält sich entgegengesetzt zu „Disallow“: Er erlaubt Suchrobotern den Zugriff auf eine bestimmte Seite oder ein bestimmtes Verzeichnis, auch wenn andere Anweisungen in der Datei robots.txt den Zugriff darauf verbieten.
Betrachten Sie ein Beispiel:
User-agent: *
Disallow: /admin/
Allow: /admin/login.html
In diesem Beispiel wird festgelegt, dass Robotern der Zugriff auf das Verzeichnis /admin/ nicht gestattet ist , mit Ausnahme der Seite /admin/login.html , die zum Indizieren und Scannen zur Verfügung steht.
Robots.txt und Sitemap
Eine Sitemap ist eine XML-Datei, die eine Liste der URLs aller Seiten und Dateien der Website enthält, die von Suchmaschinen indexiert werden können. Wenn ein Suchroboter auf die robots.txt-Datei zugreift und einen Link zu einer Sitemap-XML-Datei sieht, kann er diese Datei verwenden, um alle verfügbaren URLs und Ressourcen der Website zu finden. Die Anweisung wird im folgenden Format angegeben:
Sitemap: https://yoursite.com/filesitemap.xmlDiese Regel wird üblicherweise am Ende des Dokuments platziert, ohne an einen bestimmten User-Agent gebunden zu sein, und wird ausnahmslos von allen Robots verarbeitet. Wenn der Site-Betreiber keine sitemap.xml verwendet, ist das Hinzufügen der Regel nicht erforderlich.
Beispiele für konfigurierte Robots.txt
Einrichten von Robots.txt für WordPress
In diesem Abschnitt betrachten wir eine vorgefertigte Konfiguration für WordPress. Wir untersuchen, wie der Zugriff auf vertrauliche Daten blockiert und der Zugriff auf die Hauptseiten zugelassen wird.
Als fertige Lösung können Sie den folgenden Code verwenden:
User-agent: *
# Block access to files containing confidential data
Disallow: /cgi-bin
Disallow: /wp-admin/
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /xmlrpc.php

# Allow access to the main site pages
Allow: /wp-content/uploads/
Allow: /sitemap.xml
Allow: /feed/
Allow: /trackback/
Allow: /comments/feed/
Allow: /category/*/*
Allow: /tag/*

# Prohibit the indexing of old versions of posts and parameterized queries to avoid content duplication or suboptimal indexing.
Disallow: /*?*
Disallow: /?s=*
Disallow: /?p=*
Disallow: /?page_id=*
Disallow: /?cat=*
Disallow: /?tag=*

# Include the sitemap (location needs to be replaced with your own)
Sitemap: http://yourdomain.com/sitemap.xml
Obwohl alle Richtlinien mit Kommentaren versehen sind, wollen wir uns nun eingehender mit den Schlussfolgerungen befassen.
- Roboter indizieren keine vertraulichen Dateien und Verzeichnisse.
- Gleichzeitig wird Robotern der Zugriff auf die Hauptseiten und Ressourcen der Site gestattet.
- Um die Duplizierung von Inhalten zu verhindern, ist die Indizierung alter Versionen von Beiträgen und parametrisierten Abfragen verboten.
- Zur besseren Indizierung wird der Standort der Sitemap angegeben.
Daher haben wir ein allgemeines Beispiel einer fertigen Konfiguration betrachtet, in der einige vertrauliche Dateien und Pfade vor der Indizierung verborgen sind, die Hauptverzeichnisse jedoch zugänglich sind.
Im Gegensatz zu vielen gängigen Content-Management-Systemen oder individuell entwickelten Websites bietet WordPress mehrere Plugins, die das Erstellen und Verwalten der robots.txt-Datei erleichtern. Eine der beliebtesten Lösungen hierfür ist Yoast SEO.
Um es zu installieren, müssen Sie:
- Gehen Sie zum WordPress-Administrationsbereich.
- Wählen Sie im Abschnitt „Plugins“ die Option „Neu hinzufügen“ aus.
- Suchen Sie das Plugin „Yoast SEO“ und installieren Sie es.
- Aktiviere das Plugin.
Um die robots.txt-Datei zu bearbeiten, müssen Sie:
- Gehen Sie im Seitenmenü des Admin-Bereichs zum Abschnitt „SEO“ und wählen Sie „Allgemein“ aus.
- Gehen Sie zur Registerkarte „Tools“.
- Klicken Sie auf „Dateien“. Hier werden Ihnen verschiedene Dateien angezeigt, darunter auch die robots.txt.
- Geben Sie die erforderlichen Indexierungsregeln entsprechend Ihren Anforderungen ein.
- Nachdem Sie Änderungen an der Datei vorgenommen haben, klicken Sie auf die Schaltfläche „Änderungen an robots.txt speichern“.
Beachten Sie, dass jede robots.txt-Dateieinstellung für WordPress individuell ist und von den spezifischen Anforderungen und Funktionen der Website abhängt. Es gibt keine universelle Vorlage, die ausnahmslos für alle Ressourcen geeignet ist. Dieses Beispiel und die Verwendung von Plugins können die Aufgabe jedoch erheblich vereinfachen.
Manuelles Einrichten der Robots.txt
Ebenso können Sie die Dateikonfiguration auch ohne ein fertiges CMS für Ihre Website einrichten. Laden Sie dazu die robots.txt-Datei in das Stammverzeichnis Ihrer Website hoch und legen Sie die erforderlichen Regeln fest. Hier ist ein Beispiel mit allen verfügbaren Anweisungen:
User-agent: *
Disallow: /admin/             # Prohibit access to the administrative panel
Disallow: /secret.html	      # Prohibit access to a specific file
Disallow: /*.pdf$	      # Prohibit indexing of certain file types
Disallow: /*?sort=	      # Prohibit indexing of certain URL parameters
Allow: /public/		      # Allow access to public pages
Sitemap: http://yourdomain.com/sitemap.xml # Include the sitemap
So überprüfen Sie die Robots.txt-Datei
Als Hilfsmittel bei der Überprüfung der robots.txt-Datei auf Fehler empfiehlt sich die Nutzung von Online-Diensten.
Nehmen wir als Beispiel den Yandex Webmaster- Dienst. Um zu überprüfen, ob die Datei bereits auf den Server hochgeladen wurde, müssen Sie im entsprechenden Feld einen Link zu Ihrer Website einfügen. Anschließend lädt das Tool die Konfigurationsdatei automatisch. Alternativ können Sie die Konfiguration auch manuell eingeben.
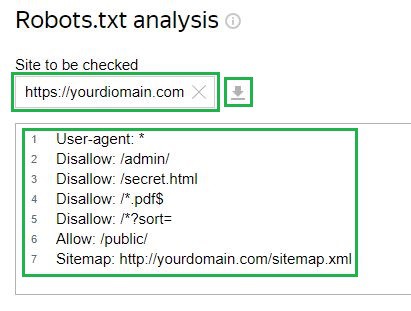
Als nächstes müssen Sie eine Überprüfung anfordern und auf die Ergebnisse warten:
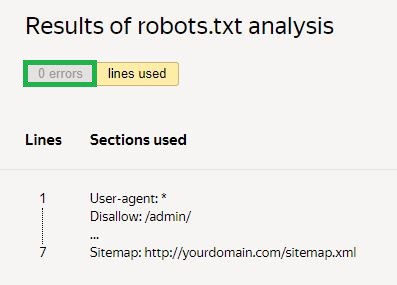
Im vorliegenden Beispiel liegen keine Fehler vor. Sollten Fehler vorliegen, zeigt der Dienst die Problembereiche und deren Behebung an.
Fazit
Zusammenfassend haben wir die Bedeutung der robots.txt-Datei für die Steuerung des Website-Verkehrs hervorgehoben. Wir haben Tipps zur korrekten Einrichtung gegeben, um die Indexierung von Seiten durch Suchmaschinen zu steuern. Darüber hinaus haben wir Beispiele für die korrekte Verwendung dieser Datei vorgestellt und Anleitungen zur Überprüfung der korrekten Funktion aller Einstellungen gegeben.
